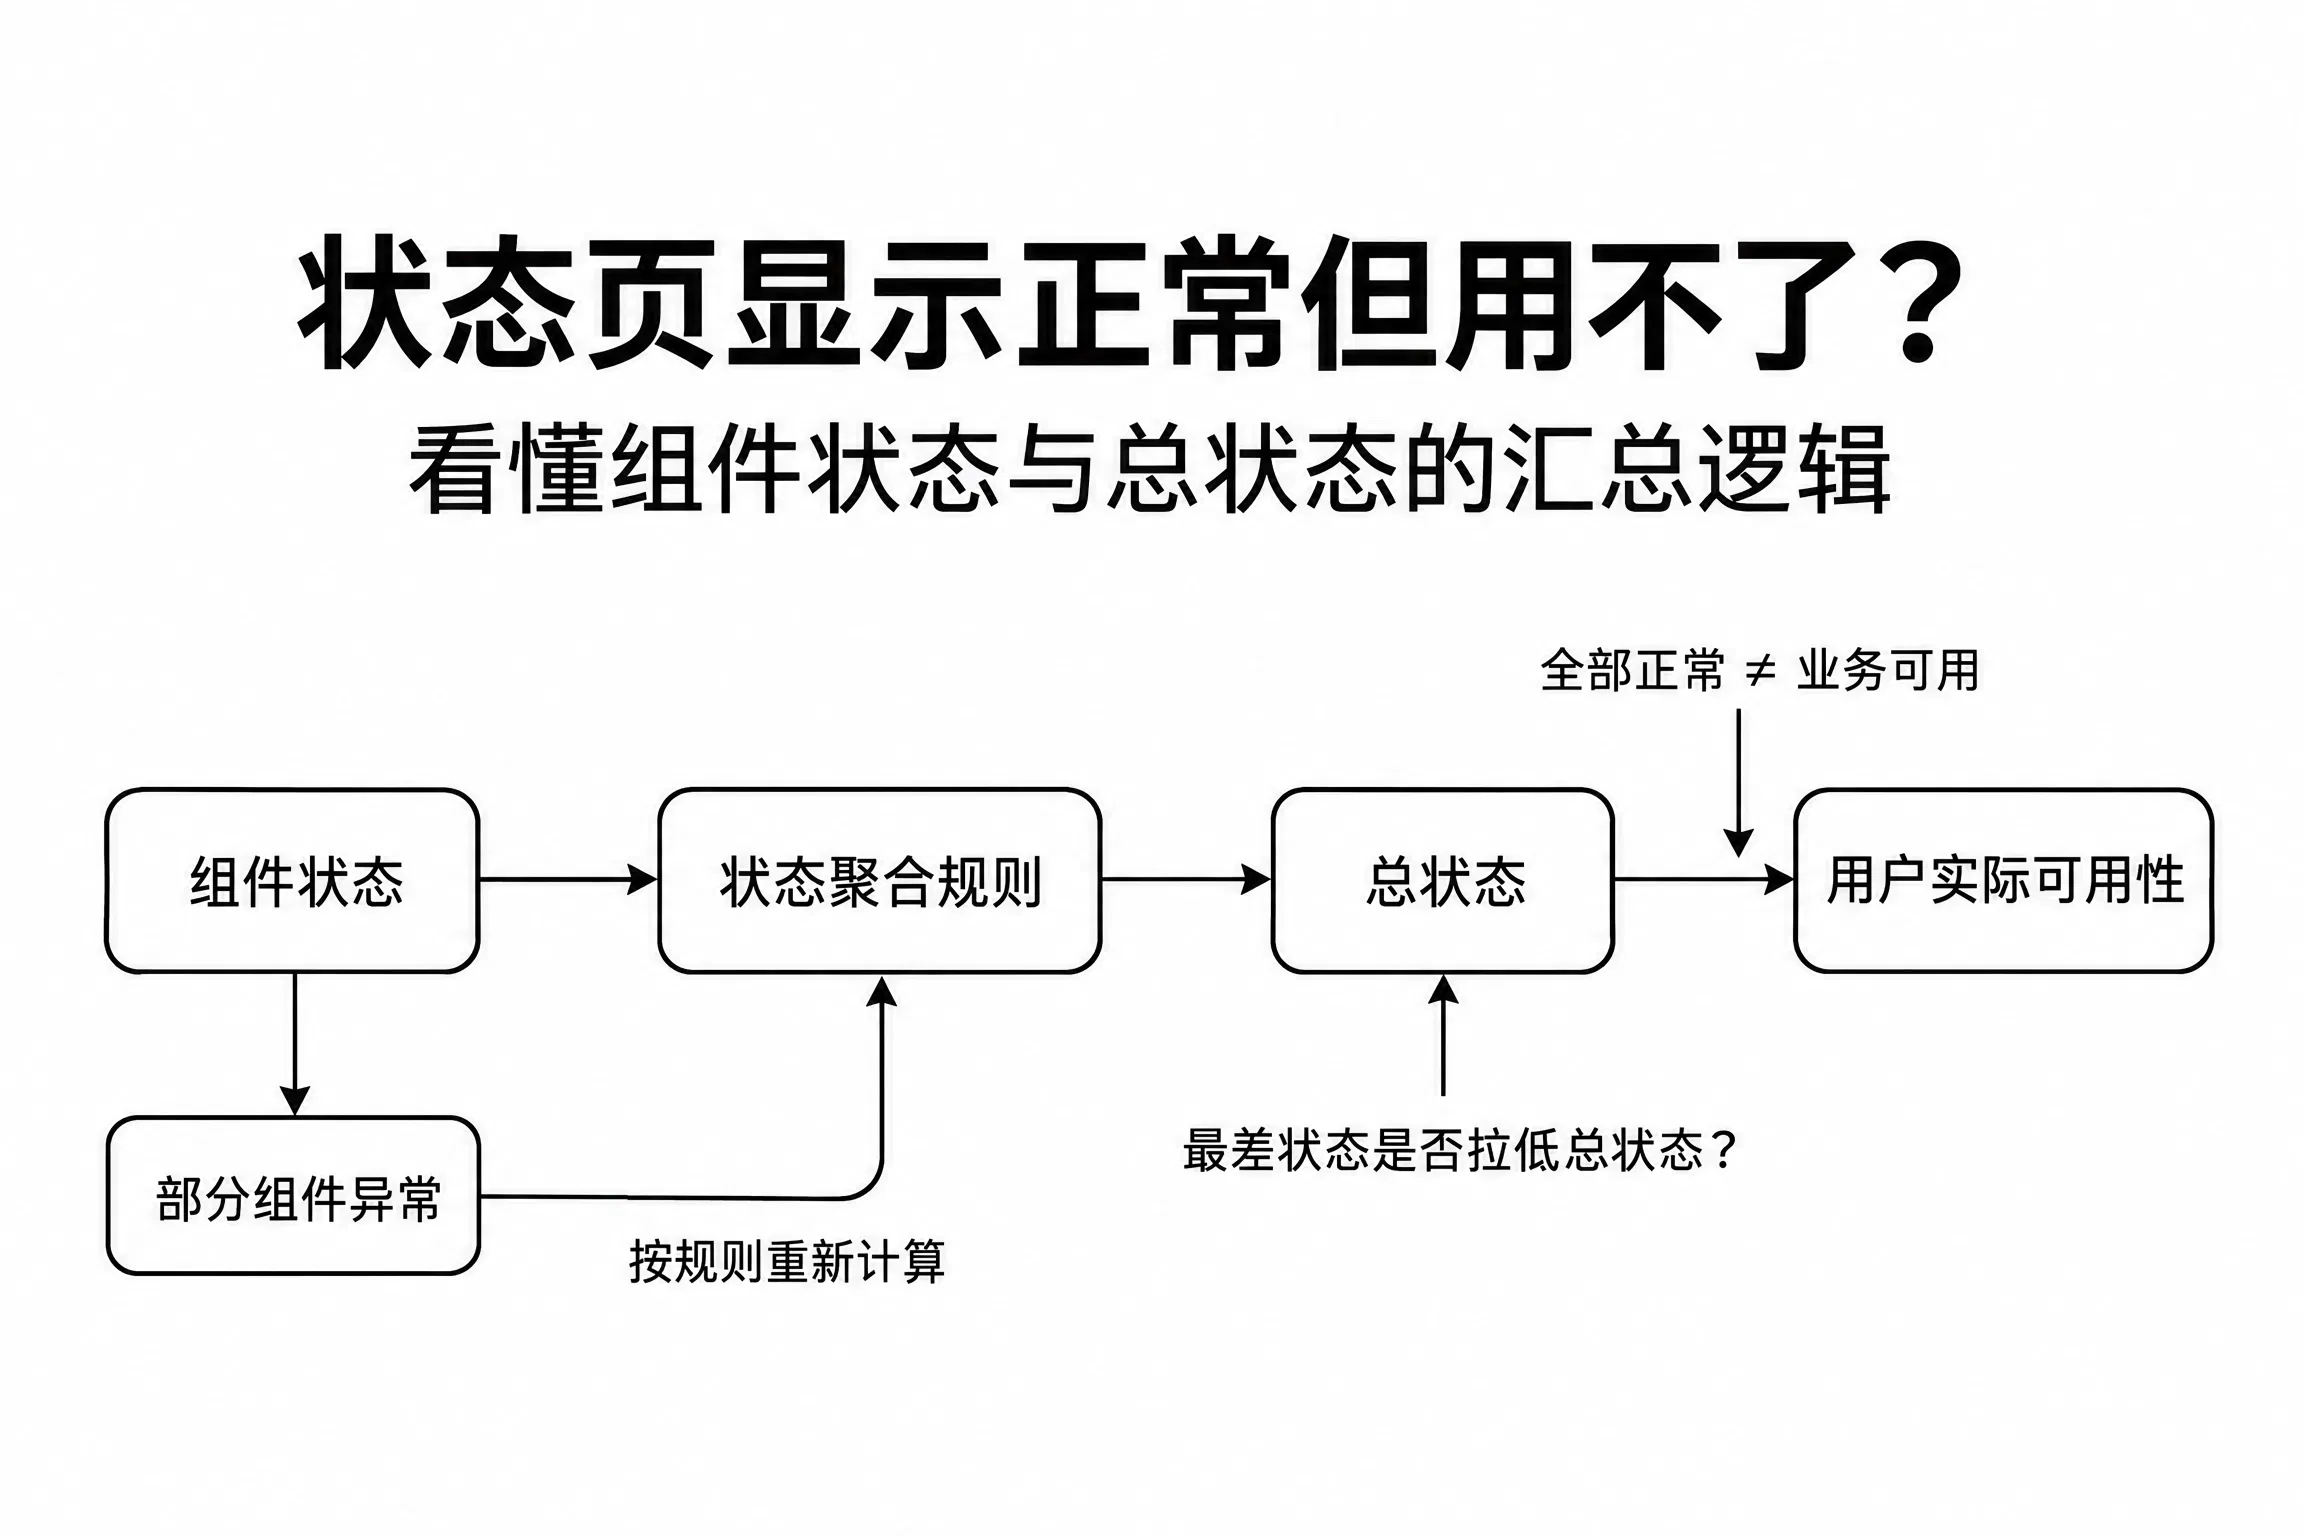
状态页绿色“运营中”不代表你用的功能正常——总状态只是所有组件的加权平均值,局部故障可能被平均数掩盖。本文拆解 Statuspage 组件状态与页面总状态的差异逻辑,教你三步自查:定位具体组件、核对状态标签、确认受影响范围(区域/租户/版本)。
服务状态页显示正常但实际不可用,是因为页面总状态仅反映整体统计平均值,无法精准呈现用户遭遇的局部组件故障。
你盯着屏幕,顶部的绿色“运营中”标签明明在闪烁,可点击某个功能时却提示连接失败。这种割裂感并非错觉,而是状态计算逻辑的必然结果。很多时候,页面总体状态只是全量数据的统计平均值,它无法精准反映你当前正在遭遇的局部困境。
为什么“运营中”会骗人?核心在于汇总逻辑的盲区
运营中”标签具有欺骗性,因为它本质是加权汇总结果,只要多数非核心模块正常,关键模块的高影响故障仍会被掩盖。
当看到绿色的“运营中”标签时,用户往往误以为整个服务生态都完好无损。实际上,这个标签本质上是所有组件状态的加权汇总[1]。只要大多数非核心模块运行正常,即便少数关键模块发生了高影响故障,总开关依然会保持绿色。
这就好比一栋大楼里只有三楼漏水,物业公告仍可能写着“大楼整体运营正常”,但这无法改变你家里没水的现实。单一的颜色或等级标签,根本无法承载复杂的局部变量。它既不能区分故障是否仅发生在特定区域、特定租户账号,还是仅限某个软件版本[2]。
这里存在一个极易被外行误解的环节:很多人认为“重大中断(Major Outage)”意味着整个平台瘫痪,或者反过来认为只要有一个组件报红,总状态就一定会变红。真相恰恰相反:厂商在标记事件时,通常只针对受影响的特定组件集合发布“高影响”通告,而页面总状态的计算逻辑是“多数决”。如果一家云服务商有50个组件,其中49个完全正常,仅核心的“登录认证”组件报错,系统可能会给该事件打上“重大中断”的标签(因为对你来说天塌了),但在计算总状态时,由于其余49个组件拉高了平均分,总开关依然显示为绿色的“运营中”。若只依赖页面总体状态,用户极易忽略那些被平均数掩盖的局部灾难。可信的公告必须同时具备三个要素:总体状态、受影响的具体组件以及明确的适用范围[3]。维护通知、实时事件与已知问题共享同一套信息链:时间界定影响何时发生,范围界定谁可能受损,触发条件解释复现规律,规避方案降低损失,修复状态说明后续行动[4]。这一模式需要多源信息合并才能还原真相,任何单一来源都无法提供统一模板[5]。
因此,不要试图从单一颜色推断全部事实。当“运营中”与你的实际体验冲突时,真正的故障往往藏在被汇总数据忽略的角落。
拆解 Statuspage 机制:如何从组件状态推导页面状态
Statuspage 机制将状态拆解为底层具体组件与上层汇总页面两层,理解差异才能破解总体状态显示正常而局部失效的现象。
Statuspage 把状态拆解成了两层:底层是具体的组件状态,上层是汇总后的页面总状态。理解这两者的差异,是破解“假绿”现象的关键。
组件级状态与页面总状态的差异逻辑
Statuspage 定义了五种标准的组件状态枚举:Operational(正常)、Under Maintenance(维护中)、Degraded Performance(性能下降)、Partial Outage(部分中断)和 Major Outage(重大中断)[1]。这些定义构成了整个体系的基石,但它们的适用范围仅限于该单一产品体系,其他平台未必采用相同的标准[1]。
在这个框架下,事件影响(incident impact)的计算依赖于关联的具体组件。如果一个数据库组件报错,它会被标记为”Major Outage”,但这仅代表该局部单元。页面总体状态则是基于页面内全部组件的状态综合计算得出的结果[1]。这就好比工厂里一条流水线坏了,整厂产量可能只是轻微下滑,甚至因为备用线路开启而维持“正常”运转,但坏掉的那台机器确实已经停摆。
目前缺乏一套公开的统一公式,能将事件影响精确映射到各严重等级。这意味着不同厂商在处理逻辑上存在差异,导致同样的故障在不同平台上呈现的汇总结果可能截然不同[1]。因此,页面显示”Operational”与某个具体事件被标记为高影响并不矛盾:前者是全量组件的统计平均值,后者仅针对受波及的局部范围。
| 状态层级 | 计算依据 | 典型表现 | 用户感知偏差 |
|---|---|---|---|
| 组件状态 | 单个服务单元 | 某 API 接口报错 | 用户直接遭遇连接失败 |
| 页面总状态 | 所有组件汇总 | 整体显示绿色正常 | 用户以为服务完全可用 |
| 事件影响 | 关联受影响组件 | 标记为“重大中断” | 仅特定区域或租户受损 |
| 维护通知 | 计划内变更 | 标记为“维护中” | 预期内的短暂不可用 |
| 性能下降 | 响应延迟数据 | 标记为“性能下降” | 操作卡顿但未完全断连 |
当页面显示“运营中”时,往往意味着大多数组件运行正常,足以拉高整体评分。但如果你发现无法使用特定功能,说明问题出在未被拉高的少数组件上[2][3][5][4]。这种信息不对称要求你必须跳出对单一颜色标签的依赖,转而检查具体受影响组件的列表。可信的公告应同时交代总体状态、受影响组件和适用范围,而不是让用户从单一等级推断全部事实[1]。
遇到服务状态页显示正常但实际用不了怎么办?三步查清受影响范围
解决状态页显示正常却连不上的问题,需跳过单一颜色指示,直接检查具体组件状态及其对应的受影响资源范围。
页面总开关亮着绿光,你手中的请求却频频报错。要解开这个死结,必须跳过那抹单一的颜色,直接去抓具体的组件和适用范围。
如何识别真正的故障范围
厂商揭示问题的关键,在于“受影响资源列表”。Azure 等服务商不会只扔给你一个总状态,而是列出具体哪些资源、区域或租户受到了波及[2]。判断的核心标准很明确:忽略总体颜色的误导,转而关注组件的状态标签和适用范围描述。
为了更直观地理解这种差异,我们可以引入另一个视角:AWS 的可用性区域(Region)隔离机制。在某些场景下,即使 AWS 全球总状态显示绿色,也可能出现“东京区域”的 S3 服务完全不可用,而“弗吉尼亚区域”的服务毫发无损的情况。此时,总状态页上的绿色是真实的,因为它代表全球大部分区域正常;但对于身处东京的用户而言,这就是典型的“局部灾难”。这种“区域级故障”往往比“全局故障”更难通过简单的颜色判断,因为它们需要用户将自身所在的地理位置与公告中的“受影响区域”列表进行交叉比对,而非仅仅看那个大色块。
维护通知、实时事件与已知问题虽然处于不同阶段,却共享同一条信息链。它们共同回答了五个具体问题:时间界定影响何时发生,范围界定谁可能受影响,触发条件解释何时复现,规避方案降低当前损失,修复状态说明后续行动[3][5]。这一模式由多种来源合并后才能识别,任何单一来源都不会明示统一的模板[4]。
| 信息维度 | 维护通知侧重 | 实时事件侧重 | 已知问题侧重 |
|---|---|---|---|
| 核心目的 | 预告计划内变动 | 响应突发异常 | 记录历史遗留问题 |
| 时间界定 | 未来特定窗口期 | 当前发生时刻 | 过去已发生时段 |
| 范围界定 | 指定区域/功能 | 关联的具体组件 | 受影响的版本/配置 |
| 用户动作 | 调整业务节奏 | 切换备用方案 | 检查兼容性设置 |
| 最终状态 | 预计完成时间 | 正在修复中 | 已有临时规避措施 |
可信公告应交代总体状态、受影响组件和适用范围,帮助用户从局部真相中识别真实故障[4]。当页面显示”Operational”时,它只是全页面组件的统计结果,并不代表所有关联组件都完好无损[1]。
自查只需三步。第一步,找到故障对应的具体组件,而非只看总标题;第二步,查看该组件的详细状态标签,确认是”Degraded Performance”还是”Partial Outage”;第三步,核对适用范围描述,判断你的账号、区域或版本是否在被列出的名单里。只有把这三层信息拼在一起,你才能看清真正的故障边界,而不是被一个绿色的总开关蒙蔽双眼。
建立“组件 - 区域”快速对照表不要等到故障发生时才去翻找公告。建议你立即访问你所依赖服务的状态页(如 Azure、AWS 或 GitHub),找到“受影响组件”列表,并手动创建一个本地文档或电子表格。将你的业务系统所依赖的关键组件名称(例如 “API Gateway”, “Database Core”)与你所在的物理区域(例如 “Asia-Pacific Tokyo”, “US-East-1”)作为第一列和第二列填入。每次遇到服务异常时,先打开这份对照表,直接勾选你所在区域的对应组件状态。这种方法能帮你将原本需要几分钟的阅读排查过程压缩到几秒钟,并有效避免因“总状态正常”而产生的自我怀疑。
常见问题解答 (FAQ)
Q: 为什么我看到的状态页是绿色的,但我还是无法登录?A: 这通常是因为页面总体状态是基于所有组件的平均值计算的。只要大部分服务正常,总标签就会显示绿色,但您遇到的可能是某个特定组件状态异常导致的局部故障。请查看下方的“受影响组件”列表以获取准确信息。
Q: 如何判断故障是否影响我的账户?A: 不要只看颜色,务必阅读公告中的“范围界定”部分。厂商通常会明确指出受影响的区域、租户 ID 或软件版本。如果不在列表中,您的账户可能未受影响,或者故障是偶发的网络波动。
Q: “性能下降”和“部分中断”有什么区别?A: “性能下降”通常指响应变慢或偶尔超时,服务仍可用;而“部分中断”意味着某些功能完全不可用,但其他功能正常。两者都属于非全局故障,容易被绿色的总状态掩盖。
参考来源
Top-level status and incident impact calculations | Statuspage | Atlassian Support · https://help.statuspage.io/help/component-status-incident-impact-and-top-level-status-calculations(A级)
Windows Autopilot 已知问题 | Microsoft Learn · https://learn.microsoft.com/zh-cn/autopilot/known-issues(A级)
Google SRE - Root Cause Analysis for Probing Incident · https://sre.google/workbook/incident-response/(A级)
服务运行状况和连续性 - Service Descriptions | Microsoft Learn · https://learn.microsoft.com/zh-cn/office365/servicedescriptions/office-365-platform-service-description/service-health-and-continuity(A级)
维护通知 - Azure Virtual Machines | Microsoft Learn · https://learn.microsoft.com/zh-cn/azure/virtual-machines/maintenance-notifications(A级)